Dlaczego gRPC nie jest szybsze od REST w Node.js
Moja praca inżynierska to tracker portfela kryptowalut podzielony na trzy serwisy w Node.js. Główne API rozmawia w nim z serwisem logowania przez gRPC. Wybrałem gRPC, bo byłem przekonany, że jest szybsze od REST. Kiedy w końcu zmierzyłem gRPC vs REST w Node.js, w szybkiej sieci wygrało zwykłe HTTP z JSON-em, więc w moim układzie się myliłem. Ten sam test w Go wyszedł odwrotnie: gRPC było równie szybkie albo szybsze prawie wszędzie. Wolny jest nie sam protokół, tylko jego implementacja w Node.js.
W skrócie
- gRPC to RPC po HTTP/2: opisujesz serwis w pliku
.protoi wołasz zdalne metody jak zwykłe funkcje.- W Node.js w szybkiej sieci REST wygrał z
@grpc/grpc-jsprzy małych wiadomościach: 0,22–0,31 ms kontra 0,39–0,58 ms na wywołanie.- W Go to samo małe wywołanie wyszło na remis, a przy dużych listach gRPC było 2–3 razy szybsze.
- W Node.js większość straty przy dużych wiadomościach brała się z
@grpc/proto-loader: zapis przez niego trwał 35–41 ms, a przez ts-proto 6–10 ms.- Na wolnych łączach, 100 i 20 Mbit/s, gRPC wygrało w obu językach, bo jego wiadomości są o około 45% mniejsze.
Jak działa gRPC
RPC, czyli remote procedure call, to wywołanie funkcji, która działa na innej maszynie, tak jakby była lokalna. gRPC to framework RPC od Google: serwis i jego wiadomości opisujesz w pliku .proto, generator robi z tego typowanego klienta i szkielet serwera, a wywołania idą po HTTP/2 jako binarne Protocol Buffers.
Różnica względem REST polega na tym, gdzie siedzi kontrakt. W REST to umowa: adres, metoda, kształt JSON-a, czasem plik OpenAPI, który potrafi rozjechać się z kodem. W gRPC kontraktem jest plik .proto i to z niego generuje się obie strony.
Jak gRPC działało w inżynierce
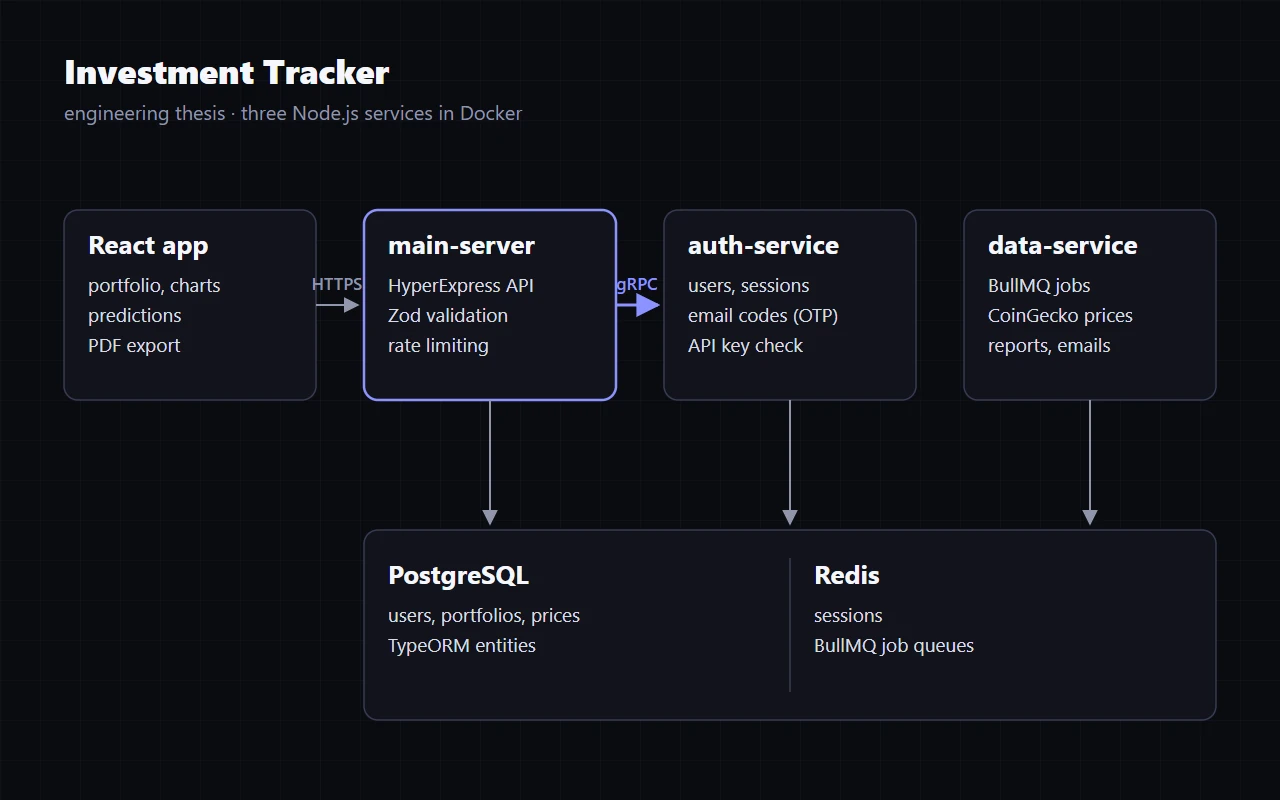
Aplikacja w React rozmawia z main-server przez HTTPS. Każde zapytanie zalogowanego użytkownika schodzi potem poziom niżej: main-server pyta auth-service przez gRPC, czy sesja jest ważna. To wywołanie między serwisami leci przy każdym zapytaniu, więc to ono mnie interesowało. Trzeci serwis odpala zadania w BullMQ i gRPC w ogóle nie używa.
Kontrakt w skrócie:
service AuthService {
  rpc LoginWithEmail(LoginWithEmailRequest) returns (LoginResponse);
  rpc ValidateSession(ValidateSessionRequest) returns (ValidateSessionResponse);
  rpc Logout(LogoutRequest) returns (LogoutResponse);
}

message ValidateSessionResponse {
  bool isValid = 1;
  string message = 2;
  optional string entityId = 3;
  int32 ttl = 4;
  bool extended = 5;
  string sessionId = 6;
}
Cały serwis ma 11 metod. Pola extended i ttl obsługują przedłużanie sesji: kiedy auth-service ją przedłuży, main-server odświeża ciasteczko. Tak wygląda middleware w main-server:
const userObject = await AuthSDK.validateSession(sessionId);

if (userObject.extended) {
  res.cookie("sessionToken", userObject.sessionId, userObject.ttl * 1000, {
    path: "/",
    httpOnly: true,
    secure: true,
    sameSite: "none",
  });
}
req.locals.user = { ...req.locals.user, uid: userObject.entityId, sessionId };
Serwisy uwierzytelniają się nawzajem kluczem API wysyłanym w metadanych gRPC. W auth-service sprawdza go interceptor, zanim odpali się jakakolwiek metoda. Zły klucz dostaje status 16 UNAUTHENTICATED, a brak wymaganego pola 3 INVALID_ARGUMENT. To standardowe kody statusu gRPC, więc nie musiałem wymyślać własnego formatu błędów.
Start z protoc i generowanym kodem
Zacząć z gRPC jest trudniej niż z REST. Przy REST wystarczy fetch i JSON w body. W gRPC, zanim zadziała pierwsze wywołanie, trzeba mieć protoc, plugin do swojego języka, właściwe opcje i miejsce na wygenerowane pliki. Na tym zeszło mi najwięcej czasu przy konfiguracji.
Skończyło się na jednym skrypcie npm we wspólnej paczce, z ts-proto:
{
  "scripts": {
    "proto:generate": "protoc --plugin=./node_modules/.bin/protoc-gen-ts_proto --ts_proto_out=./clients --ts_proto_opt=esModuleInterop=true,outputServices=grpc-js,useOptionals=messages --proto_path=./protos ./protos/*.proto"
  }
}
outputServices=grpc-js generuje typowanego klienta pod @grpc/grpc-js. Dalej każda zmiana szła już tak samo: poprawiam .proto, odpalam skrypt, a TypeScript pokazuje każde miejsce, które przestało pasować. Wygenerowany klient działa na callbackach, więc owinąłem go w małe SDK, które zwraca Promise i dokleja klucz API:
validateSession: (sessionId: string): Promise<ValidateSessionResponse> =>
  new Promise((resolve, reject) => {
    const meta = new Metadata();
    meta.add("Authorization", ApiKey);
    authClient.validateSession({ sessionId }, meta, (err, res) => {
      if (err) return reject(err);
      resolve(res);
    });
  }),
Jak mierzyłem gRPC vs REST
Przy pisaniu inżynierki niczego nie mierzyłem, więc zrobiłem to teraz, możliwie blisko tamtego układu:
- serwer w jednym kontenerze Dockera, klient w drugim, na jednym komputerze z Windows 11 i Dockerem 28.2
- Node.js 22.18: serwer gRPC ładuje
.protoprzez@grpc/proto-loader0.8 jak auth-service, klient jest wygenerowany przez ts-proto 2.7 jak w main-server, oba na@grpc/grpc-js1.14. REST to zwykłenode:httpz agentem keep-alive - Go 1.23:
grpc-go1.67 kontranet/httpzencoding/json - dwie wiadomości: 84-bajtowa odpowiedź sesji z inżynierki i lista aktywów z 500, 5000 albo 20 000 pozycji. W protobufie ważą 41 KB, 422 KB i 1,7 MB, w JSON-ie 73 KB, 748 KB i 3,1 MB
- cztery sieci: zwykła sieć Dockera, szybka i prawie bez opóźnień, potem 1 Gbit/s z opóźnieniem 0,5 ms, 100 Mbit/s z 1 ms i 20 Mbit/s z 20 ms, trzy ostatnie ustawione przez
tc netem - trzy rundy na każdy układ. W każdej jest rozgrzewka, potem wywołania jedno po drugim do mediany, a na koniec 50 wywołań naraz do liczby zapytań na sekundę. Zakresy to najniższy i najwyższy wynik z rund.
Medianę liczy ta pętla:
async function medianLatency(call, n) {
  for (let i = 0; i < 500; i++) await call();
  const times = [];
  for (let i = 0; i < n; i++) {
    const start = process.hrtime.bigint();
    await call();
    times.push(Number(process.hrtime.bigint() - start) / 1e6);
  }
  times.sort((a, b) => a - b);
  return times[Math.floor(n / 2)];
}
Małe wiadomości: w Node.js wygrał REST, w Go remis
Sprawdzenie sesji, mediana jednego wywołania:
| Sieć | Node gRPC | Node REST | Go gRPC | Go REST |
|---|---|---|---|---|
| Sieć Dockera | 0,39–0,58 ms | 0,22–0,31 ms | 0,29–0,30 ms | 0,28–0,30 ms |
| 1 Gbit/s, 0,5 ms | 0,92–1,07 ms | 0,77–0,84 ms | 0,79–0,81 ms | 0,80–0,81 ms |
| 100 Mbit/s, 1 ms | 1,46–1,60 ms | 1,30–1,37 ms | 1,33–1,38 ms | 1,36–1,39 ms |
| 20 Mbit/s, 20 ms | 21,3–22,0 ms | 20,9–21,3 ms | 20,7–20,8 ms | 20,9 ms |
Przy 50 wywołaniach naraz w sieci Dockera Node obsługiwał 6,7–9,4 tys. zapytań na sekundę przez gRPC i 13,4–18,0 tys. przez REST. Go: 44,5–54,9 tys. przez gRPC i 37,2–42,9 tys. przez REST.
Właśnie to wywołanie leci w inżynierce przy każdym zapytaniu. 74 bajty mniej nie dają żadnej mierzalnej różnicy, a @grpc/grpc-js dokłada pracy do każdego wywołania. Nie profilowałem, gdzie dokładnie idzie ten czas, więc nie podzielę go na ramki HTTP/2, nagłówki i metadane. Opiekun biblioteki sam pisze, że w jej optymalizację włożono „dużo mniej pracy” niż w gRPC dla Javy, w grpc-node#1539.
Dało się za to sprawdzić liczbę połączeń: gRPC puszcza wszystkie wywołania jednym połączeniem HTTP/2, a klient REST miał 50 gniazd. Z 8 połączeniami gRPC, ustawionymi przez grpc.use_local_subchannel_pool, Node przy liście 500 pozycji wyciągał 1,6–1,9 tys. zapytań na sekundę zamiast 1,1–1,2 tys., dalej mniej niż REST z 2,8–3,0 tys. Przy sprawdzaniu sesji nic się nie zmieniło.
Duże wiadomości: gRPC w Go wygrało wszędzie, w Node.js tylko na wolnym łączu
Lista aktywów, mediana jednego wywołania:
| Sieć | Pozycji | Node gRPC | Node REST | Go gRPC | Go REST |
|---|---|---|---|---|---|
| Sieć Dockera | 500 | 0,80–0,88 ms | 0,56–0,69 ms | 0,52–0,55 ms | 1,08–1,22 ms |
| Sieć Dockera | 5000 | 6,7–10,0 ms | 4,0–4,5 ms | 1,9–2,2 ms | 6,8–7,6 ms |
| Sieć Dockera | 20 000 | 41–51 ms | 19–23 ms | 9–12 ms | 28–34 ms |
| 1 Gbit/s, 0,5 ms | 500 | 1,65–1,69 ms | 1,68–1,69 ms | 1,34–1,42 ms | 2,07–2,34 ms |
| 1 Gbit/s, 0,5 ms | 5000 | 14,6–19,5 ms | 10,7–13,9 ms | 5,6–5,8 ms | 12,1–15,4 ms |
| 1 Gbit/s, 0,5 ms | 20 000 | 76–84 ms | 45–46 ms | 20–23 ms | 47–56 ms |
| 100 Mbit/s, 1 ms | 500 | 5,4–5,6 ms | 7,9–8,3 ms | 5,2–5,3 ms | 8,2–8,5 ms |
| 100 Mbit/s, 1 ms | 5000 | 47–51 ms | 68–69 ms | 39 ms | 70–71 ms |
| 100 Mbit/s, 1 ms | 20 000 | 196–205 ms | 274–275 ms | 153–154 ms | 282–287 ms |
| 20 Mbit/s, 20 ms | 500 | 38–39 ms | 51,7–52,0 ms | 38 ms | 51,7–51,8 ms |
| 20 Mbit/s, 20 ms | 5000 | 283–286 ms | 339 ms | 199 ms | 340–341 ms |
| 20 Mbit/s, 20 ms | 20 000 | 1127–1136 ms | 1318–1321 ms | 751 ms | 1324–1327 ms |
gRPC w Node.js przegrywało w szybkich sieciach, przy 500 pozycjach na 1 Gbit/s zremisowało, a wygrało dopiero na wolnym łączu. gRPC w Go wygrało każdy przypadek z dużą wiadomością.
Skąd strata Node.js przy dużych wiadomościach
Na czas wywołania składają się dwie rzeczy: przygotowanie i odczytanie wiadomości oraz wysłanie jej bajtów. Na wolnym łączu decyduje wysyłanie. Przy 100 Mbit/s lista ważąca 748 KB w JSON-ie potrzebuje na sam przesył około 60 ms, a 422 KB w protobufie około 34 ms, więc mniejszy format wygrywa niezależnie od języka.
W szybkiej sieci przesył jest prawie darmowy i decyduje procesor. Zapis i odczyt listy 20 000 pozycji, mierzone osobno, trzy razy:
| Krok | Czas |
|---|---|
JSON.stringify |
9,0–10,5 ms |
JSON.parse |
8,5–10,2 ms |
zapis protobufa przez @grpc/proto-loader |
34,6–41,0 ms |
| zapis protobufa przez ts-proto | 5,9–9,9 ms |
| odczyt protobufa przez ts-proto | 7,9–13,1 ms |
@grpc/proto-loader przed zakodowaniem przepuszcza każdą odpowiedź przez fromObject z protobufjs i to ten krok kosztuje najwięcej. Samo kodowanie jest tak szybkie jak JSON. Żeby to sprawdzić, przepiąłem serwer w Node z proto-loadera na definicje serwisów wygenerowane przez ts-proto. W sieci Dockera lista 20 000 pozycji zajęła wtedy 25–31 ms przez gRPC i 22–31 ms przez REST, a 5000 pozycji 5,9–6,3 ms kontra 6,0–6,4 ms. Zamiast przegranej o połowę wyszedł remis. Przy małych wiadomościach nic się nie zmieniło, bo koszt każdego wywołania został.
W inżynierce auth-service ładuje .proto przez proto-loader. Przy małych wiadomościach o sesji nie ma to dużego znaczenia, ale w serwisie, który wysyła duże listy, generowałbym teraz także kod serwera.
Czego ten test nie pokazuje
Wszystko działało na jednym komputerze, więc klient i serwer walczyły o ten sam procesor. Nie było TLS-a, był jeden kształt wiadomości, po jednym procesie Node na stronę, a wolne łącza symulował tc netem, nie prawdziwa sieć. Wyniki Go pochodzą z tego samego komputera i tego samego Dockera, więc dobrze nadają się do porównania z Node w tym teście, ale do niczego więcej.
Co gRPC i tak mi dało
- Jeden kontrakt. Plik
.protojest jedynym źródłem prawdy i obie strony generuje się z niego. Zmiana nazwy pola psuje build, a nie produkcję. - Wygenerowane typy. ts-proto generuje wszystkie interfejsy zapytań i odpowiedzi. Przy REST pisze się je ręcznie po obu stronach albo stawia generowanie z OpenAPI.
- Standardowe błędy i metadane. Kody statusu i metadane na klucz API, bez własnego formatu błędów.
- Mniejsze wiadomości. O 44–47% w każdym teście, co opłaca się na wolnym łączu.
- Deadline’y w standardzie. Klient mówi, ile czeka, a po tym czasie wywołanie kończy się błędem
DEADLINE_EXCEEDED.
Kiedy gRPC, a kiedy REST
| gRPC, kiedy | REST, kiedy |
|---|---|
| wołają się nawzajem twoje serwisy i chcesz jednego kontraktu | API wołają przeglądarki albo firmy z zewnątrz |
| serwisy są w Go, Javie albo innym języku z dojrzałą biblioteką gRPC | serwisy są w Node.js, wiadomości są małe, a sieć szybka |
| wiadomości są duże albo łącze wolne | chcesz sprawdzić endpoint curlem i przeczytać odpowiedź |
| potrzebujesz streamingu w obie strony | liczy się cache HTTP po adresie |
Przeglądarka nie zawoła gRPC bezpośrednio. Potrzebuje gRPC-Web i proxy po drodze. Dlatego aplikacja w React w inżynierce używa REST, a gRPC jest tylko między serwisami.
Co bym zostawił
Zostawiłbym podział: REST na zewnątrz, gRPC między serwisami. Zmieniłby się powód. Wybrałem gRPC dla szybkości, a w Node.js w jednej szybkiej sieci mój test przy sprawdzaniu sesji żadnej nie pokazał. W Go by pokazał. Dziś w Node.js brałbym gRPC dla kontraktu, generowałbym kod serwera przez ts-proto zamiast ładować .proto w trakcie działania, a na szybkość liczyłbym tylko tam, gdzie łącze jest wolne albo serwisy nie są pisane w Node.